
▶平日 毎朝7時に公式LINE@で新着記事を配信しています。友達申請はこちらから!
▶ICCの動画コンテンツも充実! Youtubeチャネルの登録はこちらから!
「AIやデータの活用が企業経営のあり方を大きく変える」8回シリーズ(その3)は、現状のAIが抱える課題について。IBM東京基礎研究所 元所長の森本典繁さんは、私たちが解決するべき課題の1つとして「学習過程のブラックボックス化」があると語ります。ぜひご覧ください!
▶ICCパートナーズではコンテンツ編集チームメンバー(インターン)の募集をすることになりました。もし興味がございましたら採用ページをご覧ください。
ICCサミットは「ともに学び、ともに産業を創る。」ための場です。毎回200名以上が登壇し、総勢900名以上が参加する。そして参加者同士が朝から晩まで真剣に議論し、学び合うエクストリーム・カンファレンスです。次回 ICCサミット KYOTO 2019は2019年9月3〜5日 京都開催を予定しております。
本セッションは、ICCサミット KYOTO 2017のプラチナ・スポンサーとして、IBM BlueHub様にサポート頂きました。

▼
【登壇者情報】
2017年9月5〜7日開催
ICCサミット KYOTO 2017
Session 4B
AIやデータの活用が企業経営のあり方を大きく変える
Supported by IBM BlueHub
(スピーカー)
安宅 和人
慶應義塾大学 環境情報学部 教授
ヤフー株式会社 CSO(チーフストラテジーオフィサー)
森本 典繁
日本アイ・ビー・エム株式会社
執行役員 研究開発担当
矢野 和男
株式会社 日立製作所 フェロー、理事 / 博士(工学)
IEEE Fellow
東京工業大学大学院 情報理工学院 特定教授
(モデレーター)
山内 宏隆
株式会社HAiK
代表取締役社長
▲
▶「AIやデータの活用が企業経営を大きく変える」の配信済み記事一覧
連載を最初から読みたい方はこちら
最初の記事
1. “産業のAI化は国策レベルの取り組みであり、その変化は不可逆である”――『AI白書』に見る世界のAI動向
1つ前の記事
2. 企業価値は「目先の利益」ではなく「未来を創り出す力」にシフトする
本編
山内 AIとデータの最先端の活用事例について、森本さんはいかがでしょうか?
IBM社もいろいろと変わってきていると思いますが。
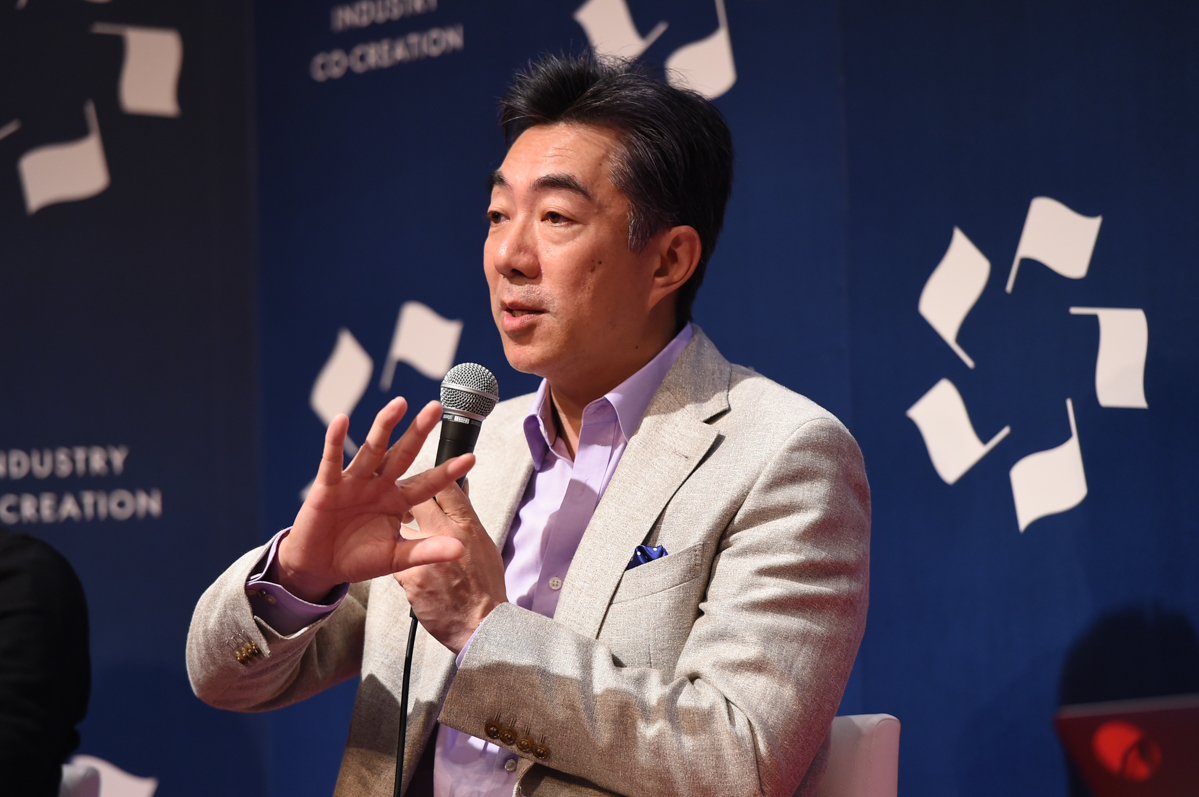
森本 典繁さん(以下、森本) 好きなことを話していいということですので、お話しさせていただきます(笑)。
▼
森本 典繁
日本アイ・ビー・エム株式会社
執行役員 研究開発担当
1987年入社後、メインフレームやPC用のCRT及び液晶ディスプレイの開発を担当。1995年、米国マサチューセッツ工科大学留学を経てIBM東京基礎研究所に転入し、以後、音声、画像、映像処理と著作権保護技術、モバイル・コンピューティングの研究プロジェクト・リーダ等を担当。2004にIBM Business Consulting出向、2006年に米国IBMワトソン研究所赴任を経て、2009年にIBM東京基礎研究所所長。2015年にIBM Asia Pacificに転出しChief Technology Officerを担当し、2017年より現職。コグニティブ・コンピューティング、グローバルな研究開発組織の運営に関して複数の著作あり。
▲
今はAIに関する辞書のように厚い教科書が出てきたりしていて、AIはやや“出来上がった”感があるかと思います。
ですが、技術を提供させていただいている我々からすると、AIはまだまだ黎明期、始まったばかりであるということが言えます。
IBMでは、この1年間での米国での発明取得が8,088件に上り、24年間連続で世界で1番となりました(2018年には年間9,100件の発明権利取得で、26年連続世界一位を継続中)。
ですけれども、それでもまだまだ足りないというぐらいに、新しいテクノロジーがこれからどんどん必要になってくるんですね。
そのAIを含めたコグニティブコンピューティング(※)全体として必要な技術が、今後もまだまだ発展していくということです。
▶︎編集注:IBMが提唱する概念で、与えられた情報を処理するのではなく、人間のように、自ら理解・推論・学習するコンピューティングのこと。コグニティブ(cognitive)とは「認知」の意味。
AIにしても、いろいろなところで使われ始めていますが、本格的なエンタープライズ・プロフェッショナルユースということを考えると、不足している部分がたくさんあります。
そういった背景を踏まえて、本日はAIがもつ課題を、大きく「技術的な面」と「利用面」に分けてお話ししたいと思います。
AIの学習過程は「ブラックボックス」の中
森本 まず「技術面」の課題として上げられるのが「アルゴリズム」の課題です。
アルゴリズムの観点だけみても、たくさんの問題や課題があります。
その1つは、皆さんよくご存じのディープラーニング、機械学習のアルゴリズムについてです。
AIが学習するために必要なデータの質が良く、データ量がたくさんあると、当然機械学習の認識率や精度が上がってきます。
その中での大きな問題は、「機械学習の過程がブラックボックス化するのを、どのように解決するか」ということです。
機械学習では、たとえば大量の画像を読み込ませて、これがイヌだ、ネコだ、唐揚げだ、というような形で学習していきます。
しかし、どの映像のどのような特徴量が組み合わさってそのニューラルネットなりが形成されているかというのは、ある意味ブラックボックス化されています。
自動的にニューラルネットができ上がって、自動的に認識率が上がるということは、逆に言うと、人によるコントロールが効かないということになります。
たとえばチャットボットは、大量のチャット、すなわちインプットからレスポンスを返すため、ポリティカル・インコレクトなことを言ってしまうということもあります。
中国でもこの件について最近面白い話がありました。
山内 ありましたね。AIが共産党批判のようなことを発言したという出来事が。
▶︎参照:共産党に否定的だった中国AIサービス、「再教育」受けたもよう(ロイター)
森本 あれは本当のことなのか・本当のことではないのか、間違いなのか・間違いではないのかは議論が分かれるところですが、そのようなことが起きかねません。
かつてのルールベースのアルゴリズムですと、アルゴリズムの問題であれば、ソフトウェアのここが悪かった、と言ってデバッグができました。
しかし、ディープラーニングで得られた知識、知見、判定というのは、学習させるデータによってその挙動やパフォーマンスが決まってくるので、アルゴリズムに手を入れる様な形でのデバッグができません。
そうすると、シャットダウンするしかありません。
カジュアルなアプリケーションで面白おかしくやる、あるいはゲームのようなものをやるならいいのですが、たとえば医療の現場、政策、政治、法律といったミッション・クリティカルなケースで、そのようなことが許されるかというと、答えは否です。
映像データに対する学習と予測精度はまだ未熟
森本 それともう1つ、アルゴリズム面の課題としてタイムシーケンスなデータに対する学習がまだまだこれから、という点があります。
たとえばドライブレコードの映像をパッと瞬間的に見せられた時に、(連続した静止画像として)自転車があって、横断歩道があって、上に歩道橋があると、それぞれが何なのかを認識することはできます。
けれども、ここから次の瞬間に何が起こるのかということを予測するところまではできません。
つまり、我々人間は、子どもがボールを持って歩道橋を渡っていたら、
「もしかしたら、そのボールが落ちてくるかもしれない」
「もしかしたら、ここを走っている自転車がこっちに寄ってくるかもしれない」
お年寄りが車を運転している時には、
「もしかしたら、急にこっちへ曲がってくるかもしれない」
というリスクの可能性を想定しながら運転しているわけです。
けれども、映像などのタイムシーケンスなデータに対する機械学習では、そういう場面が起きない限り学習することができないので、顕在化していないリスクをどのようにシミュレーションし、学習させるかというのが重要な技術課題の1つとなっています。
以上がアルゴリズム面の課題です。
AIが出す答えの「正しさ」をどのように担保するか?
森本 2つ目は「データ面」の課題です。
データの面についても、データが大量にあれば自動的に学習して知識を獲得するのだと言えれば恰好いいですが、「得られた知識が本当に正しいのか」「その答えでいいのか」という検証およびフィードバックのプロセスを経ない限りは、AIシステムとしての性能は高まりません。
それを無視して、ただ闇雲に大量にデータを集めて、トレーニングをするだけでもそこそこの結果を出すことはできます。
しかし、精度の問題やベリフィケーション(結果検証)、アカウンタビリティ(説明責任)の保証がない限り、企業のビジネスプロセス、法律、医療、などのミッション・クリティカルな分野には使えないという問題があります。
あるいは、データのリフレッシュという問題もあります。
以前に学習させたデータが間違っていたことがわかったとき、あるいは新しい知識を獲得したときに、過去に使った学習データを更新して学習し直すことが本当にできるのかという問題があります。
それができない限り、古くて誤ったデータがノイズ・データとして増えていくばかりです。
データが増えることは一時期はいいかもしれないけれど、それによってノイズが増すと、いずれAIの精度が下がってくることになります。
このようにデータの質と量、そしてそのアカウンタビリティの問題は非常に重要でありながら、まだ解けていない問題です。(発言者注:2019年時点において、IBMは、この問題に対応するため、Watson OpenScaleという新たな製品およびサービス群を発表しました。)
AIを動かすには膨大な電力が必要
森本 そして3つ目の問題が、軽視されがちなのですが、ハードウェアの能力に関する問題です。
2011年にアメリカのクイズ番組『Jeopardy!』に登場したワトソン(※)には、消費電力およそ200キロワットのパワー7のコンピューター・クラスターが後ろでこのシステムを支えていました。
▶編集注:IBM Watson(IBMワトソン)とは、自然言語を学習し人間の意思決定を支援するコグニティブ・コンピューティング・システム。2011年にアメリカの人気クイズ番組『Jeopardy!』に出場、クイズ王と対戦して勝利した。
そのハードウェアが移動できないので、『Jeopardy!』のスタジオがヨークタウン・ハイツのIBMのラボに来て収録を行ったという経緯もあるくらい、大きなハードウェアのパワーが必要です。
それから、囲碁をさしたAIも、アルゴリズムがいい、ディープラーニングが偉いということはありますが、あれも実は後ろでカスタムメイドのスーパーコンピューターが動いています。
つい最近も記事に出ていましたので公表して差し支えないと思いますが、あれも280キロワット以上のパワーを必要としています。
人間の脳と比較すると数万倍から数十万倍の電力を消費しながら動いているわけです。
そのような大きなパワーを必要とするハードウェアを、一般の人が皆が等しく使えるまでにはまだまだギャップがあり、消費電力一つとって見ても、そこには「AIに対する妄想」というか、AIの普及については、過ぎた期待値というのがあります。
能力的にも、消費電力的にも、AIのためのテクノロジーとしてはまだ解決しなければいけない技術的な問題がたくさんあり、今後も多くのR&D投資が必要になってくると思っています。
AIに対して「正しく質問する能力」が問われる時代
森本 次の課題は「利用面」についてです。
AIには「Q&Aのマシン」というイメージがあるかと思いますが、たとえばAmazon Echoが置いてあっても、(休止中も耳をそばだてているらしいけれど)何か話しかけないと返ってきませんよね。
勝手に「お腹すいた?」というようには聞いてこないわけで、質問をしなければなりません。
ある大学教授が面白いことを言っていました。
授業に行っても学生がいつもガヤガヤしているので、そこである時、空き缶を1つ持って授業へ行って、それを机の上に置きまして、「私は今日はAmazon Echoです」と言ったそうなんです。
「このトピックについては何でも知っているけれども、君たちが質問しない限り何も答えないよ」と。
そのような形で冗談を言っていましたが、要は「Ask right question, know what to ask」ということです。
すなわち、質問すべきことに関する知識があって、正しい質問をしない限り、正しい答えは返ってきません。
ですから質問する能力が大事になります。
経営側から見れば、業務をやる知識があったうえで、これについてアドバイスをもらいたいという明確な目的を持ったクエスチョンが投げられない限り、AIを使っても正しい質問、意味のある回答は返ってこないということです。
雑談に応じるAIなどはいくらでもできると思います。
ですが、そこから知識を得ようとするならば、正しい質問をすることと、どのようなクエスチョンを投げたらどのような回答が返ってくるかというのを把握することは、すごく重要になります。
クイズ番組『Jeopardy!』でも回答率が94%まで上がって最終的に人間に勝ったのですが、実は質問をいかに上手く作るかというのが、番組の質を上げる上で大事な要素でした。
質問がどのように作られているかというと、「曖昧性がなく、1つの回答が返ってきて、それが正解かどうかをベリファイできる」ようにしています。
クイズ番組ですから、答えた時に、「それもいいね!」だとか「これもあってますね」なんていうわけにはいきません。
したがって「質問文を作る」というのがそもそもプロダクションの重要な価値であって、その質問がいいから回答が返ってくるのです。
Q&Aというものがしっかりできているので、知識を吸い出せる構造になっています。
皆さんが経営や実際の現場で使う場合には、そういう質問があるかどうか、どういう目的で使うかということを明確に理解したうえで投資をしないと、つまりROI(投資利益率)でペイするようにしないと、答えても変な回答しか来ないことになります。
「そのような結果になるのは、質問が悪いからだ」ということになります。
AIへの過度な依存は、評価能力の喪失を招きうる
森本 もう1つ、AIの利用面で留意すべきことは、我々人間のAIに対する「依存度」です。
AIはこれからどんどん簡単に利用できるようになっていって、どんどんツール化していって、もう文房具のようになっていきます。
今後は、“パワポ(PowerPoint)”のようにAI技術の中身が分からなくても使えるようになっていくはずです。
こうなった時に大事なのは、先ほども申し上げたように「AIによって生じた答え、結果が本当に正しいのか」を人間が判断できるか?ということであり、AIを盲目的に信じて使っていくということの危険度をしっかりと考えなくてはなりません。
私は、このことはシンギュラリティ(※)に達して映画『ターミネーター』のような世界になってしまうことよりも怖いことだと思っています。
▶︎編集注:シンギュラリティとは、未来学の概念の一つで、人工知能の知性が人間のそれを超えること。アメリカの人工知能研究の世界的権威レイ・カーツワイルが提唱した。
つまりこういうものに依存していくと、段々とそれを盲目的に信じるようになってしまいます。
例えばいま皆さんがパワポを使って「四角」を描いた時に、本当にこれは90度になっているのか確認されますか? しませんよね。
このように、誰が「この角は確かに90度になっている」と保証してくれるのですか? となってきます。
それこそ、誰もが文房具のように簡便に使えるAIが登場してきた時に、バックエンドのデータ、バックエンドの知識が、本当にその確かさをサポートしているのかどうか分からずに使い始めて、どんどん依存していき、終いには、それを評価する能力を失った時というのが一番怖いと思っています。
使っているツールからの回答を活用しつつ、その一方でどのように感覚を研ぎ澄ませながら、AIをクリティカルな目で評価できるかということです。
この能力が養われないとAIに依存的になってしまい、AIの出した答えが間違っていても合っていても分からなくなってしまいます。
山内 ありがとうございました。
ちなみに、AIにはアルゴリズム、データ、ハード、技術的な課題はまだまだありますよということなのですが、致命的にボトルネックになっていることはあるのでしょうか?
量子コンピューティングは電力問題を解決する?
森本 2つありまして、1つは「電力の問題」です。
先ほど、人間の数万倍~数十万倍と言いましたが、普通の電気のエンジニアをやっている方なら、5%、10%の電力を削減することがどれだけ大変か分かるはずです。
ここから桁を変えてまで効率を上げていくためには、完全にデバイスの構造から材料、アルゴリズムまで全部変えていくということが必要です。
そこで出てきているのが、量子コンピューターという世界です。
IBMでは5量子ビット、2017年は16量子ビットのコンピューターまで安定稼働させたうえで、皆さんにインターネット経由で使えるようにしております。
16量子ビットではまだ大した仕事はできないのですが、これから先、実用化に向けてどんどんケイパビリティを向上させていきます。
従来想像されていたよりも遥かに速いペースで実用化に向けて進んでいますが、ポイントは、今までのコンピューターがただ速くなるということではありません。
今までのスーパーコンピューターではどんなに技術が進歩して計算速度が速くなっても解けなかったNP-hardなどの問題が、量子アルゴリズムであればあっという間に解けてしまうかもしれない、という領域が存在します。
量子コンピューターはこのスイートスポットに焦点を当てるものであって、従来のコンピューターを置き換えるというよりは、それとハイブリッドになりながら動いていくものです。
この世界は電力の節約というより、そもそも非常に難しかった問題が解ける可能性があるということなんです。
また、人間の脳の方が省電力だということで、脳の仕組み、シナプスやニューロンなど、そういったもののスイッチを模したハードウェアというのは、この電力の問題を解決する1つのヒントになると思います。
▶参照:メモリ技術の革新的進化で「人間の脳レベルの電力消費効率マシン」がついに実現する?(ICC FUKUOKA 2018)
超小型コンピューターがデータ処理を変える
森本 もう1つは、大量のデータをどのように処理するかということです。
エッジやセンサーのところにインテリジェンスを持たせることによって、センサーからネットワーク側に“ダダ漏れ”してくる意味のない大量のデータを遮断して、意味のあるデータのみをフィルターアウトしたうえで投げてくる、このようなテクノロジーが非常に重要です。
そのためにも超小型のコンピューターをどんどんエッジやセンサーに実装していくようなテクノロジーが重要になっています。
こういったテクノロジーを進めることによって、多少なりとも、将来のハードウェア・クライシスを防ぐということになると思います。
山内 IBMの東京基礎研究所で特に力を入れていることはあるのでしょうか?
森本 1つは、先ほどお話しさせていただいた「ニューロモーフィック・コンピューティング」という脳の仕組みを模したコンピューターです。
そしてもう1つは、ただ今お話ししました「スーパー・ミニチュアライズド・コンピューター」というものですね。
たとえば髪の毛の太さというのは大体70マイクロメートルなのですが、髪の毛の太さと同じかそれ以下のサイズの中に、プロセッサー、メモリー、バッテリーそしてI/O(入出力モジュール)までが入った小さな装置です。
山内 そんなものができるのですか!
森本 これは多分目薬に入れて点眼してもほぼ痛くない、少しゴロゴロするくらいのサイズです。
▶参照:IBMが開発する「花粉サイズ」の世界最小コンピューターが、あらゆるデータのリアルタイム計測を実現する(ICC FUKUOKA 2018)
もちろん、飲み込んでもそのまま問題なく出てくるようなサイズです。
こうしたコンピューターがセンサーやカメラに実装できれば、たとえば「Aさんを見つけてください」とカメラレンズの中で探させて、Aさんを見つけた時だけ1ビット通信するということができるようになります。
これが実現すれば、ネットワークへの大量な無駄なデータの“ダダ漏れ”を防ぐことができますので、IoTの先のキー技術だと思っています。
こうした小型で緻密な仕事は日本が得意としている分野で、そういったものをIBMの東京基礎研究所で研究しております。
山内 なるほど、ありがとうございます。
後半の「使う側」の課題、すなわちクエスチョンを立てる能力であるとか、依存性に対してどうするのかという点については、また後半で議論できたらなと思います。
最後になってしまいましたが、矢野さん、いかがでしょうか。
矢野 和男さん もうすでに30分経っていますけれど……。
(会場笑)
山内 大丈夫です!
(続)
次の記事を読みたい方はこちら
続きは 4. 共通点は「複雑性」? ディープラーニングの原理は、企業経営そのもの をご覧ください。
▶平日 毎朝7時に公式LINE@で新着記事を配信しています。友達申請はこちらから!
▶ICCの動画コンテンツも充実! ICCのYoutubeチャネルの登録はこちらから!
編集チーム:小林 雅/本田 隼輝/尾形 佳靖/戸田 秀成/鈴木ファストアーベント 理恵
他にも多く記事がございますので、TOPページからぜひご覧ください。
更新情報はFacebookページのフォローをお願い致します。